บอกลาอุปกรณ์ DWDM ราคาแพง: โมดูลออปติคอล coherent 800G ZR/ZR+ จะออกแบบสถาปัตยกรรมการเชื่อมต่อ DCI ของคลัสเตอร์ประมวลผล AI ใหม่ได้อย่างไร?
ในปี 2026 การประมวลผล AI กลายเป็นสมรภูมิหลักที่ผู้ให้บริการคลาวด์และ ISP ต่างแย่งชิงกัน เมื่อแร็ก NVIDIA H100/H200 และแม้กระทั่งแร็ก GB30 รุ่นถัดไปถูกปรับใช้อย่างหนาแน่น สถาปัตยกรรมประมวลผลจึงกำลังเปลี่ยนจาก "การรวมศูนย์ที่ไซต์เดียว" ไปสู่ "คลัสเตอร์กระจายข้ามภูมิภาค"
แต่เมื่อการประมวลผลขยายตัวออกไป คอขวดทางกายภาพที่รุนแรงก็โผล่ขึ้นมา: ความไม่สมดุลระหว่างแบนด์วิดท์กับต้นทุนของการเชื่อมต่อประมวลผล
การเชื่อมต่อศูนย์ข้อมูล (DCI) แบบดั้งเดิมพึ่งพาอุปกรณ์ขนส่ง DWDM ราคาแพงและการจัดเส้นทางชั้นไฟฟ้า OTN ที่ซับซ้อน สำหรับคลัสเตอร์ GPU ที่เชื่อมต่อกันข้ามเมืองหรือข้ามศูนย์ จำเป็นหรือไม่ที่ต้องปรับใช้ระบบ DWDM เต็มรูปแบบให้กับทุก ๆ ลิงก์? การมาถึงของโมดูลออปติคอล coherent ดิจิทัล 800G ZR/ZR+ กำลังเปลี่ยนสมการนี้ทั้งหมด
1. จุดปวดของการเชื่อมต่อ DCI ประมวลผล AI: ทำไมแนวทางดั้งเดิมจึงสอบตกในบททดสอบด้านเศรษฐศาสตร์?
ในการฝึก AI โมเดลขนาดใหญ่ ทั้ง tensor parallelism และ expert parallelism ล้วนต้องการการแลกเปลี่ยนข้อมูลระดับมหึมาที่ถี่ยิบระหว่าง GPU ในสถานการณ์ DCI ความต้องการแบนด์วิดท์สูงเช่นนี้ก่อให้เกิดจุดปวดดังต่อไปนี้:
การลงทุนอุปกรณ์ก้อนแรกหนักอึ้ง: เพื่อบรรทุกทราฟฟิก 800G หรือ 1.6T การออกแบบดั้งเดิมต้องปรับใช้อุปกรณ์ชั้นไฟฟ้า (OTN) และชั้นออปติคอล (DWDM) ทั้งกอง ไม่เพียงกินพื้นที่แร็กที่แพงเปล่า ๆ แต่ยังผลัก CAPEX ให้พุ่งสูงขึ้นอย่างมีนัยสำคัญ
รอบการส่งมอบที่ยาวนาน: การจัดซื้อ ปรับใช้และเดินลิงก์ที่ซับซ้อนของอุปกรณ์ DWDM มักใช้เวลาหลายสัปดาห์หรือแม้กระทั่งหลายเดือน ซึ่งเป็นต้นทุนด้านเวลาที่ยอมรับไม่ได้สำหรับการเปิดตัวระบบประมวลผล AI ที่ต้องแข่งกับเวลาทุกวินาที
ข้อจำกัดด้านพลังงานและพื้นที่: ระบบ DWDM แบบดั้งเดิมกินพลังงานมหาศาล ภายใต้งบพลังงานของศูนย์ข้อมูลที่เข้มงวดขึ้นทุกที ทุกวัตต์ที่ประหยัดได้คือพื้นที่ให้ GPU เพิ่มขึ้น
เมื่อเผชิญจุดปวดเหล่านี้ โมดูลออปติคอล coherent 800G ZR/ZR+ แบบเสียบใช้ได้ทันทีจึงกลายเป็นคำตอบที่เหมาะสมที่สุดสำหรับการเชื่อมต่อคลัสเตอร์ประมวลผล AI
2. วิเคราะห์เชิงลึก: ความแตกต่างทางเทคนิคระหว่าง 800G ZR กับ ZR+ และวิธีเลือก
ในอุตสาหกรรมการสื่อสารด้วยแสง ทั้ง 800G ZR และ ZR+ ต่างเป็นสมาชิกของตระกูลโมดูล coherent ดิจิทัลด้วยกัน แต่ทั้งสองแตกต่างกันอย่างละเอียดอ่อนในการปรับใช้จริง การระบุสเปกผิดอาจทำให้ลิงก์ไม่เสถียรหรืองบประมาณสูญเปล่า
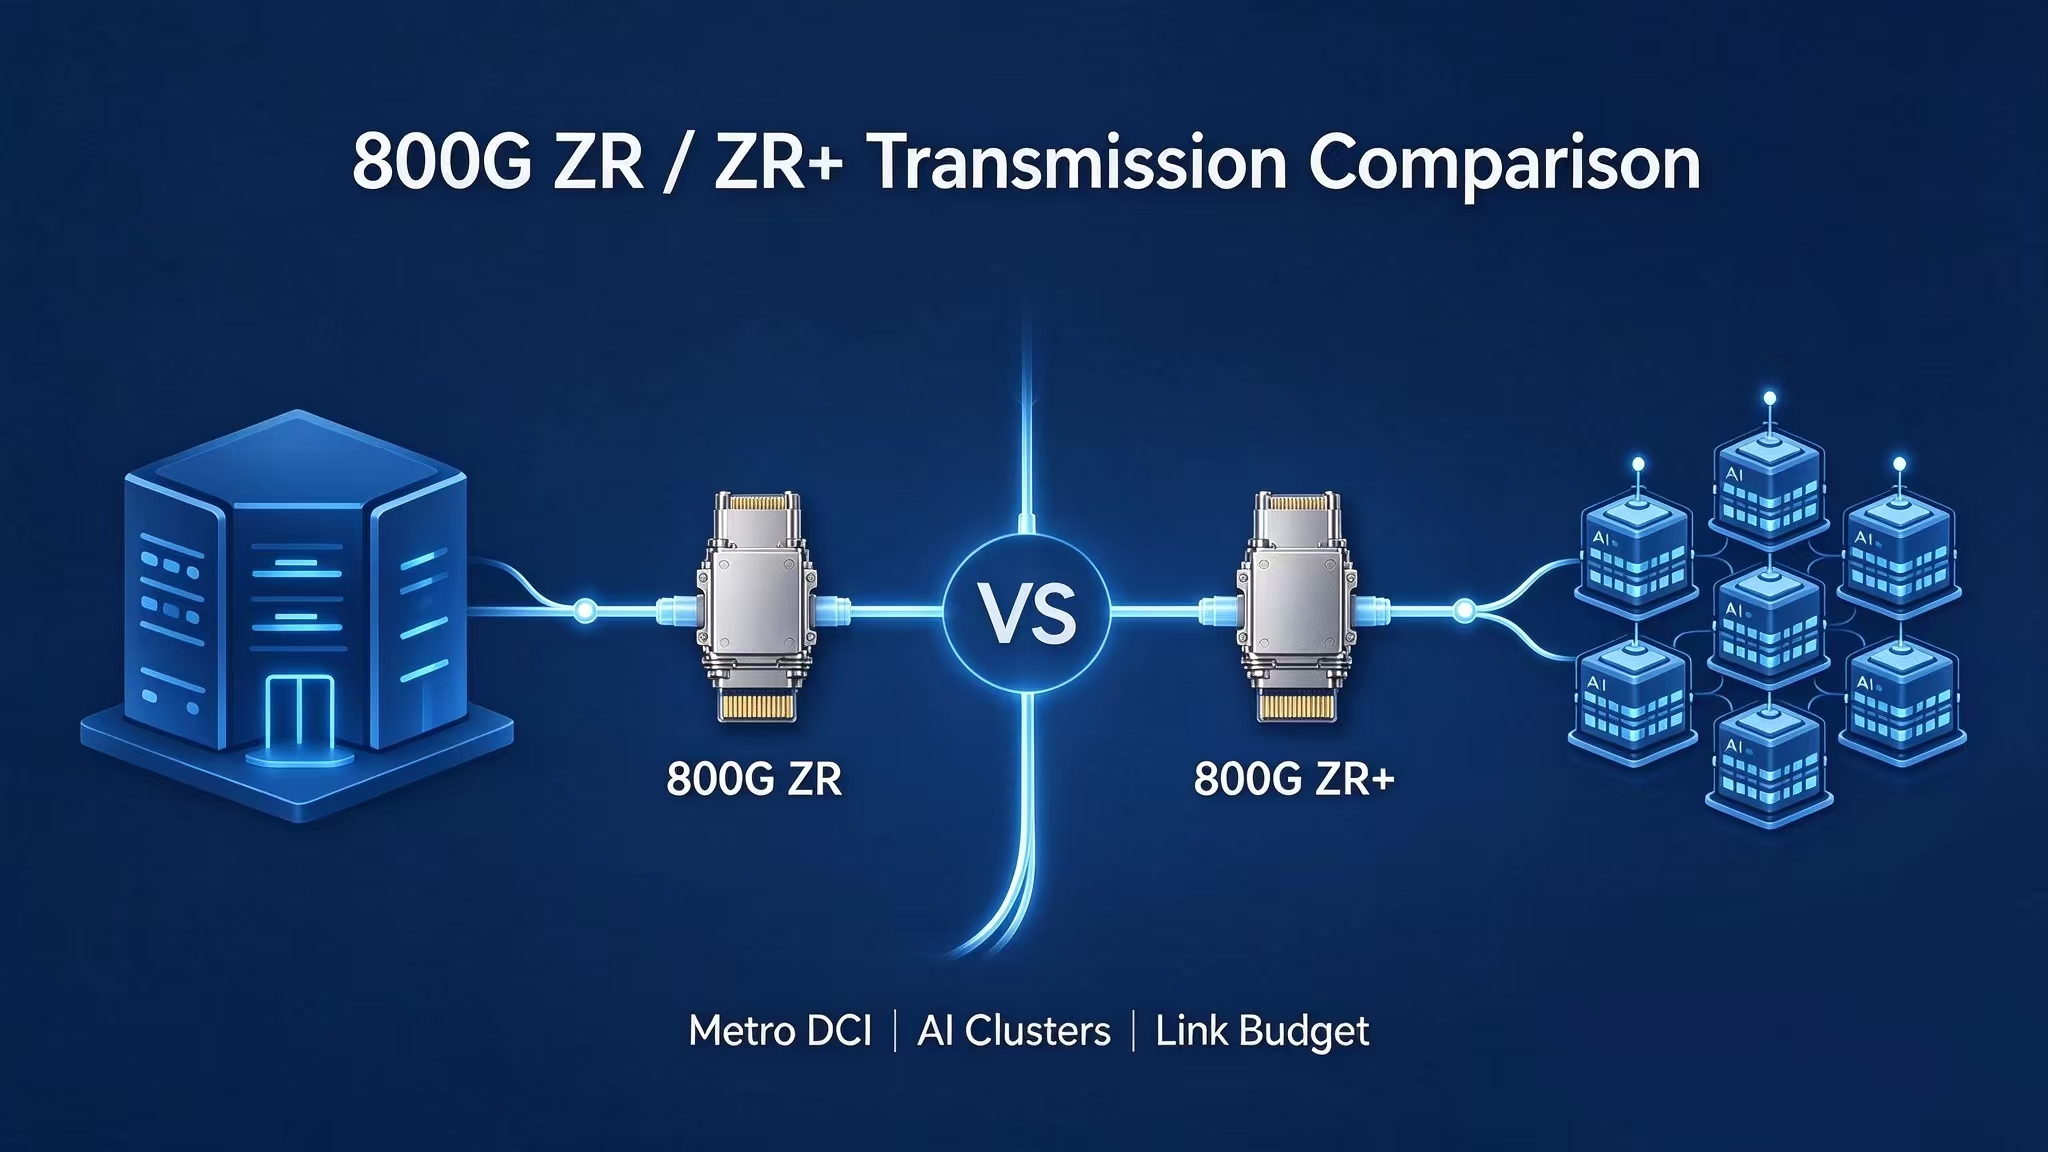
- โมดูลออปติคอล coherent 800G ZR: ทางเลือก "คุ้มค่า" สำหรับการเชื่อมต่อข้ามภูมิภาคระยะ 80km
ระยะการส่ง: ระยะไร้รีเลย์ตามแบบทั่วไปที่ 80km
OSNR และมาร์จิ้นออปติคอล: 800G ZR ถูกปรับแต่งมาเพื่อการส่งระยะกลางและมีข้อกำหนดต่อ OSNR (อัตราส่วนสัญญาณต่อสัญญาณรบกวนของแสง) ค่อนข้างต่ำ แม้ในจุดที่มาร์จิ้นของ link budget ตึงตัว 800G ZR ยังคงรักษาการสื่อสารให้เสถียร
การใช้พลังงาน: คงอยู่ราว 25W-30W จึงเหมาะกับการเชื่อมต่อศูนย์ข้อมูลความหนาแน่นสูงเป็นอย่างยิ่ง และช่วยบรรเทาแรงกดดันการระบายความร้อนในแร็ก
การใช้งานทั่วไป: การเชื่อมต่อข้ามโซนระหว่าง IDC ในเมืองเดียวกัน การแยกเชิงแสงกับเชิงไฟฟ้า (opto-electrical decoupling) สำหรับศูนย์องค์กรภายในระยะ 80km และการรวมสัญญาณ fronthaul 5G
- โมดูลออปติคอล coherent 800G ZR+: "สัตว์ร้ายแห่งสมรรถนะ" สำหรับช่วงข้ามภูมิภาคไร้รีเลย์ระยะ 200km
ระยะการส่ง: ด้วยอัลกอริทึม DSP (การประมวลผลสัญญาณดิจิทัล) ที่ยกระดับขึ้น ระยะไร้รีเลย์ขยายได้ถึง 200km หรือไกลกว่านั้น (400km+ เมื่อใช้ตัวขยายสัญญาณออปติคอล)
OSNR และมาร์จิ้นออปติคอล: โมดูล ZR+ ใช้อัลกอริทึม soft-decision FEC (การแก้ไขความผิดพลาดแบบไปข้างหน้า) ที่ล้ำหน้ากว่าซึ่งทนต่อการเสื่อมกำลังได้ดีกว่า แต่เป็นการแลกมาด้วยข้อกำหนด OSNR ที่เข้มงวดกว่า
การใช้พลังงาน: สร้างบนชิป DSP ประสิทธิภาพสูงกว่าที่มีพลังประมวลผลเหนือกว่าหลายเท่า 800G ZR+ โดยทั่วไปอยู่ในช่วง 35W-45W
การใช้งานทั่วไป: การเชื่อมต่อคลัสเตอร์ประมวลผลข้ามเมือง การเชื่อมต่อโหนด backbone ระดับประเทศ และการเชื่อมต่อข้ามภูมิภาคระหว่างศูนย์ประมวลผล AI ระดับ hyperscale
📊 เปรียบเทียบสเปกหลัก: 800G ZR vs 800G ZR+
| ตัวชี้วัดหลัก | โมดูลออปติคอล coherent 800G ZR | โมดูลออปติคอล coherent 800G ZR+ | ความแตกต่างหลัก |
| ระยะการส่ง | ≤ 80km | ≤ 200km (หรือ 400km+ เมื่อใช้ตัวขยายสัญญาณออปติคอล) | ZR+ มอบความสามารถส่งข้ามเมืองระดับสุดขั้ว |
| อัลกอริทึม DSP | soft-decision FEC ระดับความซับซ้อนปานกลาง | soft-decision FEC อันดับสูงระดับพิเศษ | ZR+ มีความทนทานต่อสัญญาณรบกวนและการแก้ไขความผิดพลาดที่แข็งแกร่งกว่า |
| พลังงานของโมดูล | ประมาณ 25W - 30W | ประมาณ 35W - 45W | ZR เหนือกว่าในสถานที่ที่ต้องการความหนาแน่นพลังงานต่ำ |
| ค่าเกณฑ์ OSNR | ค่อนข้างต่ำ พร้อมมาร์จิ้นที่ดีกว่า | ค่อนข้างสูง ต้องการลิงก์ที่สะอาดกว่า | ZR+ ต้องการความสะอาดของลิงก์ไฟเบอร์ในระดับสูง |
| สถานการณ์ที่เหมาะที่สุด | การเชื่อมต่อ IDC ในเมืองเดียวกันและศูนย์องค์กร | ศูนย์ประมวลผลข้ามเมืองและการเชื่อมต่อ backbone ระดับประเทศ | เลือกอย่างแม่นยำตามระยะช่วงจริง |
3. โมดูล 800G ZR/ZR+ เสริมพลังคลัสเตอร์ประมวลผล AI อย่างไร? (การใช้งานในโลกจริง)
สถานการณ์ที่ 1: การเชื่อมต่อความหน่วงต่ำของคลัสเตอร์ประมวลผลข้ามเมือง
ในเฟสการอนุมาน AI ทราฟฟิกมักกระจายอยู่ตามโหนดขอบ (edge node) การปรับใช้โมดูล 800G ZR+ สามารถพุ่งข้ามระยะทางทางกายภาพ 150km เพื่อเชื่อมคลัสเตอร์อนุมาน AI ในสองเมืองเข้าด้วยกันได้โดยตรง นอกจากตัดต้นทุนอุปกรณ์ DWDM แบบดั้งเดิมออกแล้ว การเชื่อมต่อตรงชั้นออปติคอลยังคงความหน่วงทางกายภาพไว้ที่ระดับมิลลิวินาที ตอบโจทย์ความต้องการจัดกำหนดการประมวลผล AI ได้อย่างสมบูรณ์แบบ
สถานการณ์ที่ 2: การขยายความจุต้นทุนต่ำภายในศูนย์ข้อมูล (Scale-Up/Scale-Out)
เมื่อสวิตช์เครื่องเดียวพัฒนาไปสู่ 51.2T หรือแบนด์วิดท์ที่สูงกว่านั้น ความต้องการแบนด์วิดท์ระหว่างแร็ก (Scale-Out) ก็พุ่งทะยาน การเสียบโมดูล 800G ZR เข้ากับหน้าเพลตสวิตช์โดยตรงส่งมอบการส่งสัญญาณ 800G ความหนาแน่นสูงบนไฟเบอร์เพียงเส้นเดียว เทียบกับโมดูล 800G DR/FR แบบเสียบได้ตามแบบทั่วไป แนวทาง coherent สามารถมัลติเพล็กซ์ความยาวคลื่นหลายความยาวคลื่น (WDM) ลงบนไฟเบอร์เส้นเดียวได้อย่างง่ายดายเมื่อทรัพยากรไฟเบอร์ตึงตัวจนขั้นสุด ทำให้ใช้ประโยชน์จาก dark fiber เดิมได้เต็มที่ที่สุด
4. คำแนะนำในการเลือก: จะเลือกโซลูชัน DCI ที่ดีที่สุดสำหรับเครือข่ายประมวลผล AI ของคุณอย่างไร?
เมื่อเลือกระหว่างโมดูล 800G ZR และ ZR+ โปรดใส่ใจกับปัจจัยหลักต่อไปนี้และหลีกเลี่ยงกับดัก:
วัด OSNR และ dispersion จริงของลิงก์: อย่าไล่ล่าระยะส่งสูงสุดอย่างตาบอด หากช่วงระยะจริงของคุณอยู่ภายใน 50km การเลือก 800G ZR+ ถือเป็นการใช้ให้เกินความจำเป็น และการชดเชยเกินจำเป็นของ DSP ยังเพิ่มพลังงานและความหน่วงโดยไม่จำเป็น
ความเข้ากันได้และ plug-and-play: คลัสเตอร์ประมวลผล AI มักใช้สถาปัตยกรรมแบบผสมหลายผู้ผลิต โมดูล 800G ZR/ZR+ คุณภาพดีจะบรรจุ DSP แบบโปรแกรมได้ที่ปรับตัวเข้ากับแพลตฟอร์มผู้ผลิตหลักโดยอัตโนมัติ (Cisco, Juniper, Arista, NVIDIA และอื่น ๆ) เปิดใช้งานการปรับใช้แบบ zero-touch ได้อย่างแท้จริง
ความเข้ากันได้และเสถียรภาพของห่วงโซ่อุปทาน: กำลังการผลิตโมดูล coherent 800G ทั่วโลกกำลังตึงตัว และระยะเวลารอคอยของชิป DSP ต้นน้ำพร้อมชิ้นส่วน ITLA (integrated tunable laser assembly) ก็ยืดยาวออกไปเรื่อย ๆ การเลือกพาร์ตเนอร์ที่มีห่วงโซ่อุปทานมั่นคงและสต็อกเพียงพอจึงมีความสำคัญอย่างยิ่ง
โอบรับ DCI แบบลีน และสร้างรากฐานประมวลผล AI รุ่นถัดไป
ในแก่นแท้แล้ว การเชื่อมต่อประมวลผล AI มุ่งแสวงหาความหนาแน่นแบนด์วิดท์ระดับสูงสุด ความหน่วงทางกายภาพต่ำสุด และ TCO (ต้นทุนรวมของการถือครอง) ที่ดีที่สุด ในรูปแบบ "ลีน กระชับ ประสิทธิภาพสูง" โมดูลออปติคอล coherent 800G ZR/ZR+ ตอบโจทย์ทุกสิ่งที่ศูนย์ข้อมูล AI แห่งอนาคตจะเรียกร้องจากการเชื่อมต่อ DCI
ปล่อยอุปกรณ์ขนส่งแบบดั้งเดิมที่อืดอาดไว้เบื้องหลัง แล้วจุดประกายเครือข่ายประมวลผล AI ของคุณโดยตรงด้วยโมดูลออปติคอล coherent 800G
👉 คุยกับผู้เชี่ยวชาญของ OTSLink: [email protected]