告别昂贵 DWDM 设备:800G ZR/ZR+ 相干光模块如何重构 AI 算力集群的 DCI 互联?
在 2026 年,AI 算力已成为云厂商与 ISP 争夺的核心战场。随着 NVIDIA H100/H200 乃至下一代 GB30 机柜的密集部署,算力架构正从“单点集中”走向“分布式跨域集群”。
然而,算力扩张的同时,一个严重的物理瓶颈开始显现:算力互联的带宽与成本失衡。
传统的数据中心互联(DCI)依赖昂贵的 DWDM 传输设备和复杂的 OTN 电层转接。而在 GPU 集群跨城或跨园区互联的场景下,我们是否必须为每一段链路都部署全套 DWDM 系统?800G ZR/ZR+ 数字相干光模块的出现,正在彻底改变这一局面。
一、 AI 算力 DCI 互联的痛点:传统方案为何“不划算”?
在 AI 大模型训练中,无论是张量并行还是专家并行,都要求 GPU 之间进行极其频繁、大规模的数据交换。这种高带宽需求在 DCI 场景下,催生了以下几个痛点:
传统设备投资过大:为了承载 800G 或 1.6T 的流量,传统方案需要部署全套电层设备(OTN)和光层设备(DWDM),这不仅占用了昂贵的机房空间(Rack Space),还大幅推高了 CAPEX。
交付周期漫长:从 DWDM 设备的采购、部署到复杂的链路调测,通常需要数周甚至数月。这对于分秒必争的 AI 算力部署来说,是无法承受的时间成本。
功耗与空间限制:传统 DWDM 系统的功耗巨大,在日益紧张的数据中心电力预算下,每节省一瓦功耗都意味着可以塞入更多 GPU。
针对这些痛点,即插即用(Plug-and-Play)的 800G ZR/ZR+ 相干光模块成为了 AI 算力集群互联的最优解。
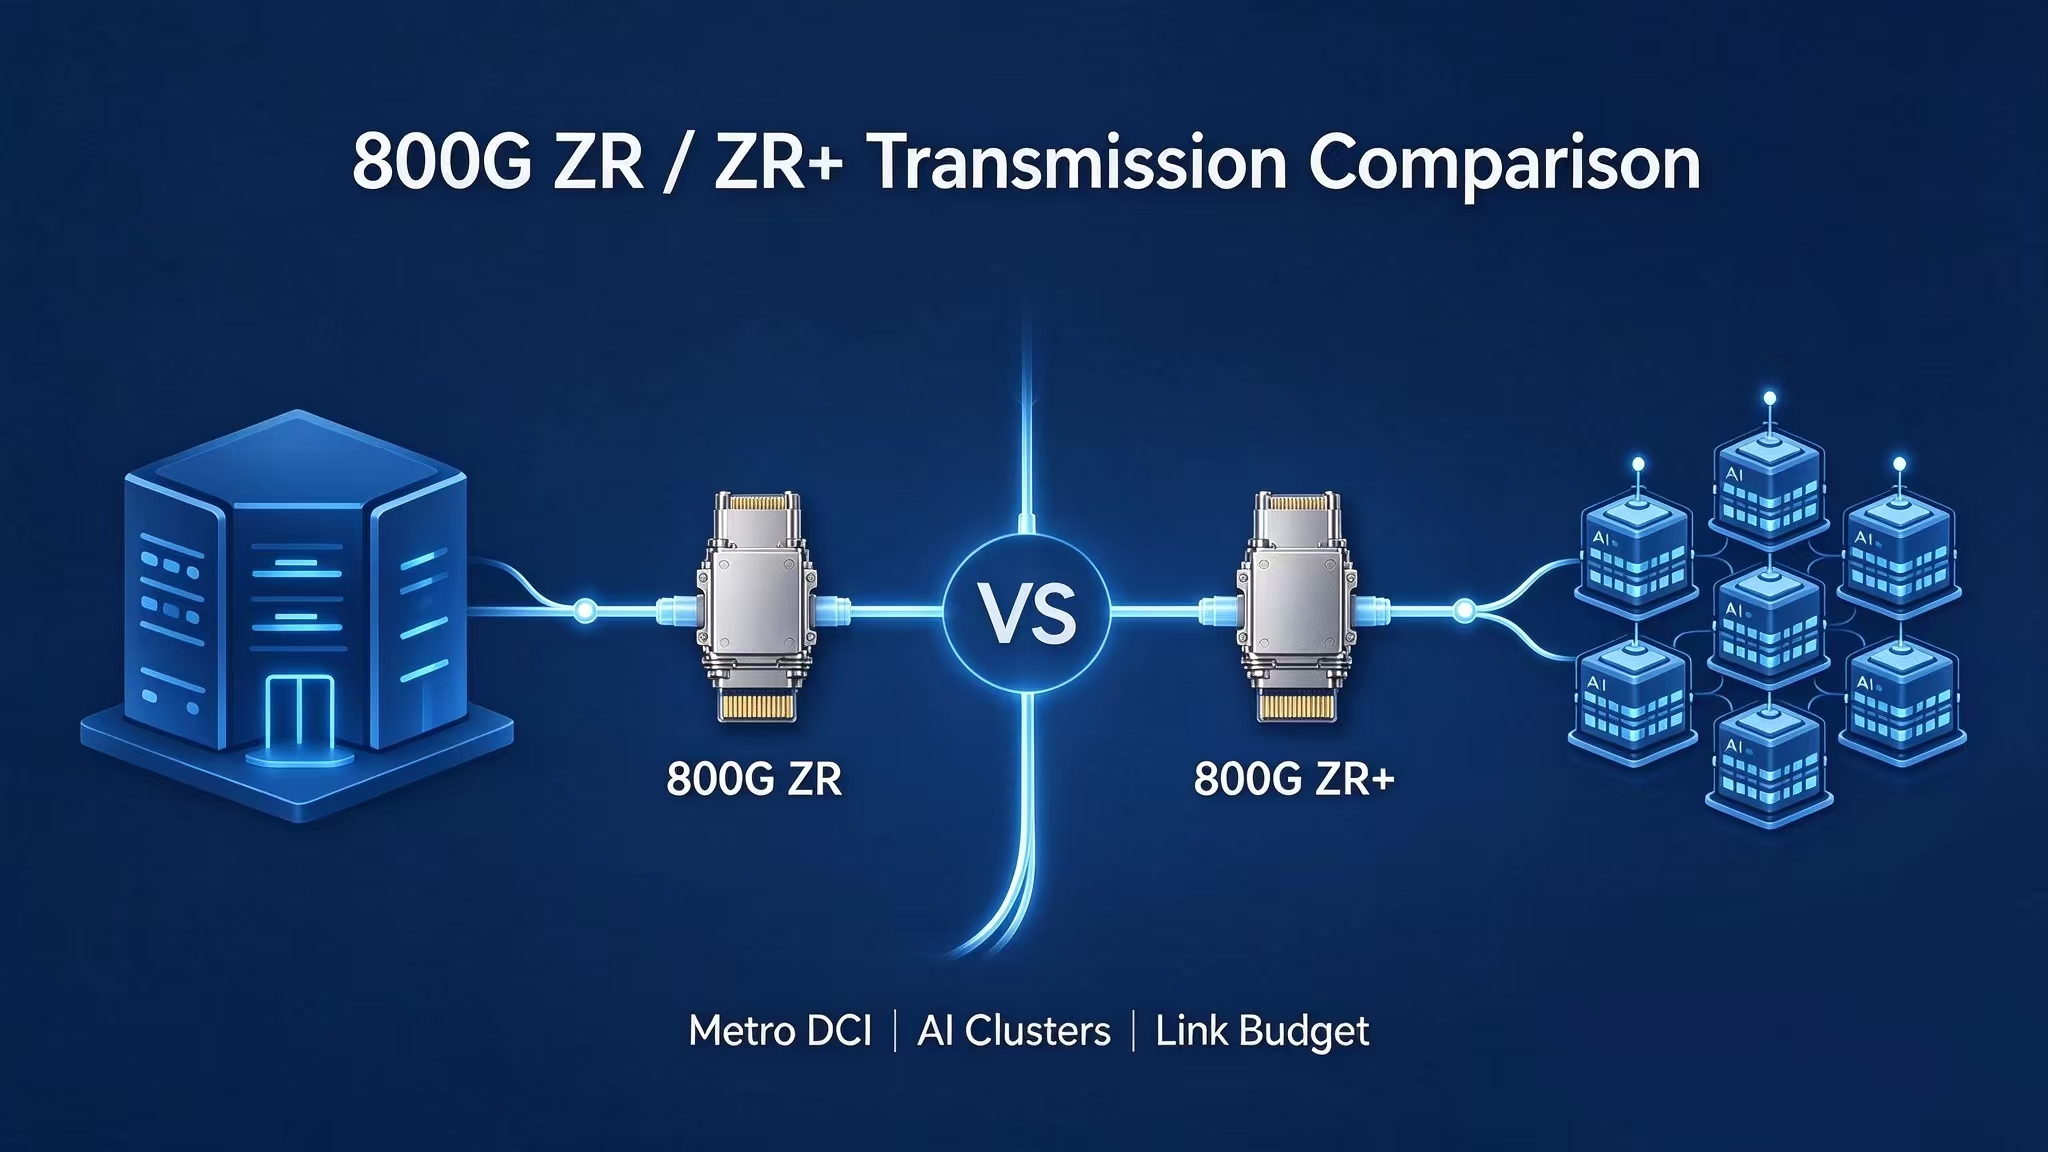
二、 深度解析:800G ZR 与 ZR+ 的技术差异与选型
在光通信行业中,800G ZR 和 ZR+ 虽然同属数字相干光模块,但在实际应用场景中却有着微妙的差异。选错规格,可能会导致链路不稳定或成本浪费。
- 800G ZR 相干光模块:80km 跨域互联的“经济实用型”
传输距离: 典型无中继传输距离为 80km。
OSNR 与光余量: 800G ZR 针对中等距离传输进行了优化,对 OSNR(光信噪比)的要求相对较低。在链路预算余量较紧的场景下,800G ZR 依然能保持稳定的通信。
功耗表现: 功耗控制在 25W-30W 左右,非常适合高密度数据中心互联,能有效降低机柜的散热压力。
典型应用: 同城 IDC 跨区互联、80km 以内的企业园区光电解耦、5G 前传汇聚等。
- 800G ZR+ 相干光模块:200km 无中继跨域的“性能猛兽”
传输距离: 通过增强型 DSP(数字信号处理)算法,无中继传输距离可高达 200km 甚至更远(配合光放大器可达 400km+)。
OSNR 与光余量: ZR+ 模块采用了更先进的软判决 FEC(前向纠错)算法,具有更强的抗衰减能力,但同时对 OSNR 提出了更严格的要求。
功耗表现: 由于搭载了更高性能、算力更强的 DSP 芯片,800G ZR+ 的功耗通常在 35W-45W 之间。
典型应用: 跨城算力集群互联、国家级骨干网节点互联、超大规模 AI 算力基地的跨域互联。
📊 核心参数对比:800G ZR vs 800G ZR+
| 核心指标 | 800G ZR 相干光模块 | 800G ZR+ 相干光模块 | 关键差异说明 |
| 传输距离 | ≤ 80km | ≤ 200km (或 400km+ 带光放) | ZR+ 拥有极致的跨城传输能力 |
| DSP 算法 | 中等复杂度软判决 FEC | 高阶超软判决 FEC | ZR+ 具有更强的抗噪与纠错能力 |
| 模块功耗 | 约 25W - 30W | 约 35W - 45W | ZR 在低功耗密度机房更具优势 |
| OSNR 阈值 | 相对较低,余量较好 | 相对较高,对链路清洁度要求高 | ZR+ 需确保光纤链路的高洁净度 |
| 最佳场景 | 同城 IDC 互联、企业园区互联 | 跨城算力枢纽、国家骨干网互联 | 根据实际跨域距离精准选型 |
三、 800G ZR/ZR+ 如何赋能 AI 算力集群?(实战应用)
场景 1:跨城算力集群的低延迟互联
在 AI 推理阶段,流量往往分散在边缘节点。通过部署 800G ZR+ 模块,可以直接跨越 150km 的物理距离,连接两个城市的 AI 推理集群。这不仅消除了部署传统 DWDM 设备的成本,还通过光层直连将物理延迟控制在毫秒级,完美满足 AI 算力调度需求。
场景 2:数据中心内部(Scale-Up/Scale-Out)的降本扩容
随着单台交换机向 51.2T 甚至更高带宽演进,机柜间(Scale-Out)的互联带宽需求激增。将 800G ZR 模块直接插入交换机面板,即可实现单纤 800G 的高密度传输。相比传统的可插拔 800G DR/FR 模块,相干方案在光纤资源极度紧张时,能轻松实现单纤多波(WDM)复用,最大化利用现有的暗光纤(Dark Fiber)资源。
四、 选型建议:如何为您的 AI 算力网络选择最佳 DCI 方案?
在选择 800G ZR 或 ZR+ 模块时,请务必关注以下几个核心要素,避免踩坑:
实测链路 OSNR 与色散:不要盲目追求最远的传输距离。如果您的实际传输距离在 50km 以内,选用 800G ZR+ 不仅大材小用,还会因为 DSP 算法的过补偿导致不必要的功耗和延迟增加。
兼容性与即插即用(Plug-and-Play):AI 算力集群通常采用多厂商混合架构。优秀的 800G ZR/ZR+ 模块应内置可编程 DSP,能够自动适配主流大厂(如 Cisco、Juniper、Arista、NVIDIA 等)的硬件平台,实现真正的免调测部署。
兼容性与供应链稳定性:目前全球 800G 相干光模块产能趋紧,上游 DSP 芯片和 ITLA(可调谐激光收发阵列)交期拉长。选择一家拥有稳定供应链和充足现货的合作伙伴至关重要。
拥抱极简 DCI,构建下一代 AI 算力底座
AI 算力互联的本质,是追求极致的带宽密度、最低的物理延迟和最优的 TCO(总体拥有成本)。800G ZR/ZR+ 相干光模块以“极简、紧凑、高性能”的形态,完美契合了未来 AI 数据中心对 DCI 互联的所有想象。
告别笨重的传统传输设备,用 800G 相干光模块直接点亮您的 AI 算力网络。
👉 联系 OTSLink 专家:[email protected]